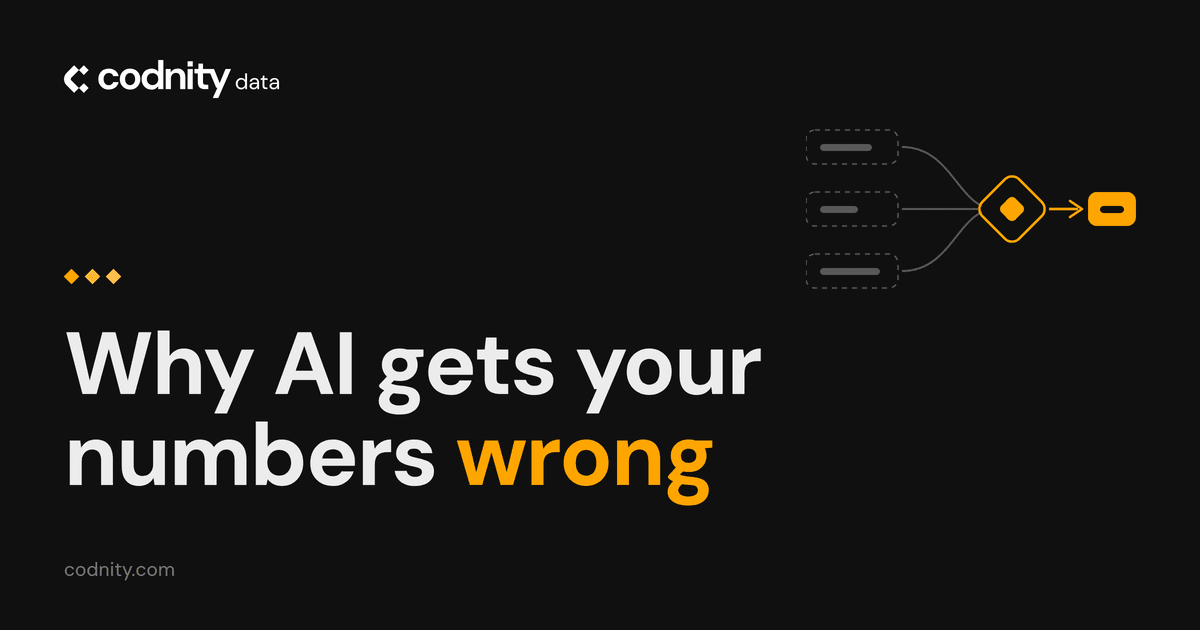
MI kļūdās ar skaitļiem tad, kad tam pašam jāuzmin, ko skaitlis nozīmē. Ja MI strādā ar neapstrādātām tabulām, tas ieņēmumu definīciju izdomā uz vietas. Ja tas strādā ar sakārtotu datu noliktavu, kurā ieņēmumi definēti vienreiz, tas nolasa to pašu skaitli, ko rāda pārskats. Risinājums ir datu modelēšana, nevis jaudīgāks MI modelis.
Šis ir iebildums, ko Codnity komanda dzird visbiežāk, un tas ir saprātīgs. Kāds pieslēdz MI asistentu uzņēmuma datubāzei, jautā, kādi bija pagājušā ceturkšņa ieņēmumi, un saņem skaitli, ko neviens neatpazīst. Acīmredzamais secinājums ir, ka MI to izdomāja.
Parasti tā nav. Tas atbildēja uz citu jautājumu nekā uzdotais.
Cik šobrīd izmaksā atbilde uz šādu jautājumu
Pirms runāt par MI, vērts apskatīt, kas notiek šobrīd, kad kādam vajadzīgs konkrēts skaitlis.
- Vadītājs vēršas pie finanšu analītiķa. Pie cilvēka, nevis pie sistēmas.
- Analītiķis eksportē datus no katras sistēmas. Grāmatvedības, CRM un operatīvās sistēmas dati, katri atsevišķā failā.
- Analītiķis sagatavo pārskatu. Eksportus viņš apvieno ar rokām, izmantojot noteikumus, kas zināmi tikai viņam.
- Analītiķis salīdzina rezultātu ar grāmatvedības datiem. Pirmajā reizē skaitļi gandrīz nekad nesakrīt.
- Analītiķis nosūta atbildi vadītājam. Tas notiek pēc vairākām dienām, kad skaitlis jau ir novecojis.
Šī ķēde ir patiesās izmaksas, un tā vienā vai otrā veidā pastāv katrā uzņēmumā, kas strādā ar eksportiem. Tāpēc arī šķiet tik vilinoši pieslēgt MI tieši datubāzei: izskatās, ka tā var izlaist visus piecus soļus.
Tā gan nav, un iemesls ir pats interesantākais.
Kāpēc MI kļūdās ar biznesa skaitļiem?
Kolēģis, kuram jautā par pagājušā ceturkšņa ieņēmumiem, atbildot ņem vērā virkni nerakstītu noteikumu. PVN netiek ieskaitīts. Darījumi starp grupas uzņēmumiem netiek ieskaitīti. Kredītrēķini tiek atskaitīti. Ieņēmumi tiek uzskaitīti pēc rēķina datuma, nevis apmaksas datuma. Neapmaksātie rēķini tomēr tiek ieskaitīti. Testa pasūtījumi tiek izņemti.
Tieši šos noteikumus analītiķis piemēro iepriekš aprakstītās ķēdes 3. solī. Tos zina tikai viņš, un tāpēc vispār ir vajadzīgs 4. solis.
Datubāzē nekas no tā nav pierakstīts. Šie noteikumi ir finanšu komandas galvās un loģikā, ko iestrādājis pēdējā pārskata veidotājs.
Tāpēc, strādājot ar neapstrādātām tabulām, MI pašam jāizdara šīs izvēles. Tas izvēlas vienu interpretāciju, pareizi veic aprēķinu un sniedz skaitli. Aritmētika ir pareiza, bet definīcija ir izdomāta.
Uzdodot vienu un to pašu jautājumu trīs reizes, var saņemt trīs dažādas, bet pamatotas atbildes, jo datos tiešām ir trīs pamatotas atbildes. Problēma nav MI modelī. Problēma ir neskaidri definētos datos.
Kāda ir atšķirība starp neapstrādātiem un modelētiem datiem?
Neapstrādāti dati ir tas, ko sistēmas pieraksta, darbojoties. Modelēti dati ir tā pati informācija pēc tam, kad kāds ir izlēmis, ko tā nozīmē.
Ražošanas datubāze ir veidota, lai ātri un droši rakstītu darījumus. Tā nav veidota, lai atbildētu uz jautājumiem. Tas izpaužas konkrēti:
- Tabulu un kolonnu nosaukumi ir izstrādātāju saīsinājumi -
ord_hdr,amt_2,flg_x - Viens un tas pats klients pastāv trīs reizes, jo trīs sistēmas to izveidojušas atsevišķi
- Biznesa noteikumi dzīvo lietojumprogrammas kodā, nevis datos
- Piecās kolonnās ir datums, un nekas neuzrāda, kura nozīmē, ka pārdošana notikusi
- Dzēstie ieraksti joprojām ir tur ar uzstādītu karodziņu
Cilvēks analītiķis šīs īpatnības apgūst mēnešiem. MI, kas shēmu lasa pirmo reizi, nekā no tā nevar zināt.
Modelēšana ir darbs, kurā šie lēmumi tiek pierakstīti vienreiz, pašos datos, lai neviens un nekas vairs nebūtu spiests minēt.
Vai MI var lasīt tieši no datubāzes?
Tehniski jā. Vairāki rīki ļauj MI asistentu pieslēgt tieši uzņēmuma darba datubāzei, un tas uzreiz sāk atbildēt uz jautājumiem.
Šai pieejai ir trīs problēmas, un tikai pirmā ir acīmredzama.
Tiek noslogota sistēma, uz kuras balstās uzņēmuma darbs. Smagi analītiski vaicājumi aktīvai darījumu datubāzei atņem resursus lietotnei. Rezultātā lēni darbojas gan pārskats, gan norēķini.
MI redz visu. Algas, personas datus un neaizsargātus klientu ierakstus. Ja piekļuve nav ierobežota pirms savienojuma izveides, tā nav ierobežota vispār.
MI nav definīciju, uz ko balstīties. Tieši tas rada nepareizus skaitļus, un to nevar atrisināt ar precīzākiem norādījumiem MI. Ieņēmumu aprēķina noteikumus tērzēšanā nav iespējams izskaidrot tik precīzi, lai divas reizes pēc kārtas saņemtu vienu un to pašu atbildi.
Ko modelēta datu noliktava patiesībā maina?
Pārvaldīta datu noliktava atrodas starp sistēmām un visu, kas tām uzdod jautājumus. Dati tiek kopēti pēc grafika, tīrīti, savienoti un definēti - pēc tam atskaites un MI lasa gatavās tabulas, nevis neapstrādātās.
Konkrēti Codnity risinājumā: savienotāji katru nakti izgūst datus no katra avota, dbt pārveido datus cauri Raw, Staging un biznesam gataviem slāņiem, un automatizēti testi uztver sliktus datus, pirms tos ieraudzījusi kāda atskaite. Tipisks vidēja izmēra uzņēmums nonāk pie aptuveni 12 tabulām un četriem miljoniem rindu - pietiekami neliels, lai būtu ātrs, pietiekami strukturēts, lai būtu viennozīmīgs.
Svarīgākā daļa ir semantiskais slānis. Neto ieņēmumi ir definēti vienreiz. Aktīvs klients ir definēts vienreiz. Bruto peļņas norma ir definēta vienreiz. Katrs informācijas panelis un katra MI atbilde šīs definīcijas pārmanto, nevis pārrēķina nedaudz citādi.
Tas nozīmē, ka jautājums maina formu. Nevis „ko šis MI domā ar ieņēmumiem“, bet „ko mūsu uzņēmums saprot ar ieņēmumiem“ - jautājums, uz kuru finanšu komanda var patiešām atbildēt, vienreiz, vienā sapulcē.
Un tas sakļauj piecu soļu ķēdi. Noteikumi, kas dzīvoja analītiķa galvā, ir ierakstīti datos, tāpēc nav ko saskaņot - atskaite un MI atbilde nāk no vienām un tām pašām definīcijām. Otrais, trešais un ceturtais solis beidz pastāvēt. Paliek jautājuma uzdošana un atbildes saņemšana, ko visi sākotnēji arī vēlējās.
Analītiķis no tā nepazūd. Viņš pārstāj sakārtot eksportus un sāk lemt, kādām jābūt definīcijām, - tas ir tas darba posms, kam vajadzēja cilvēku.
Vai ir droši dot MI piekļuvi uzņēmuma datiem?
Ir, ja piekļuve ir ierobežota, pirms MI vispār pieslēdzas, nevis pēc tam.
Codnity risinājums savienojas, izmantojot MCP ar tikai lasīšanas akreditācijas datiem. Tas nevar rakstīt, nevar dzēst, nevar mainīt definīciju. Un tas redz tikai tās tabulas, kuras jautātājam ir atļauts redzēt - mārketinga jautājums nevar sasniegt maksājumu tabulu, jo šī tabula šim cilvēkam vispār nav pieejama.
Šī pēdējā atšķirība ir svarīgāka, nekā šķiet. MI nefiltrē pilnu atbildi līdz tam, ko ir atļauts zināt. Tas datus nemaz nav saņēmis. Nav ko noplūdināt ar attapīgi formulētu jautājumu.
Katrs vaicājums tiek reģistrēts. Ja kāds jautā ko neparastu, tas ir redzams.
Kā zināt, ka atbilde ir pareiza?
Uzdodot to pašu jautājumu divos veidos.
Tā kā MI un Power BI informācijas paneļi lasa no vienām un tām pašām modelētajām tabulām, tiem jāatgriež viens un tas pats skaitlis. Kad tie sakrīt, ir divi neatkarīgi ceļi uz vienu skaitli. Kad nesakrīt, ir atrasts robs modelī - un, svarīgi, ir precīzi zināms, kur meklēt.
Tā ir praktiskā atšķirība starp modelētu datu noliktavu un asistenta pavēršanu pret datubāzi. Nevis tā, ka MI pārstāj kļūdīties. Bet tā, ka tad, kad tas kļūdās, cēlonis ir atrodams un labojams, nevis atrodas kaut kur valodas modeļa iekšienē.
No jebkura skaitļa var arī detalizēt līdz rindām, kas tam pamatā. Atbilde, ko var atvērt, ir atbilde, kurai var uzticēties.
Ko tas neatrisina
Modelēšana novērš definīciju neviennozīmību, kas ir visbiežākais nepareizu skaitļu cēlonis biznesa vidē. Tā nepadara MI nekļūdīgu.
Tas joprojām var nepareizi izprast neskaidru jautājumu. Tas joprojām var izvēlēties nepareizu mēru, kad ticami ir divi. Mainās tas, ka atgrieztie skaitļi ir reāli skaitļi no pārvaldītām tabulām, kurus var pārbaudīt - nevis ticami izskatoši rādītāji, kas salikti no shēmas, ko tas redzēja pirmo reizi.
Ikviens, kas sola, ka MI nekad nekļūdīsies ar uzņēmuma datiem, kaut ko pārdod. Reālistisks mērķis ir, lai tad, kad tas kļūdās, to varētu pamanīt, un cēloni varētu novērst vienreiz, nevis mūžīgi pārbaudīt katru atbildi.
Ar ko sākt
Ja uzņēmumā divi cilvēki var uzdot to pašu jautājumu un saņemt atšķirīgus skaitļus, ir modelēšanas problēma, un MI pievienošana tai nesamazinās nesaskaņu, bet padarīs to ātrāku.
Sākt vajag ar pierakstīšanu, ko patiesībā nozīmē pieci visvairāk strīdu izraisošie rādītāji. Šis dokuments ir semantiskā modeļa sākums, un tas ir noderīgs neatkarīgi no tā, vai MI kādreiz tiek pieslēgts kam.
Pēc tam jāizlemj, vai šo slāni veidot un uzturēt pašiem, vai uzticēt to pārvaldībai. Codnity komanda piedāvā otro - par €250 mēnesī plus €15 par lietotāju, ar ES hostingu, iekļaujot datu noliktavu, savienotājus, modeļus un ikdienas atjaunināšanu. Pirms izšķiršanās to godīgi jāsalīdzina ar datu inženiera un analītiķa izmaksām.
Biežāk uzdotie jautājumi
Kāpēc MI no datubāzes izvada nepareizus skaitļus?
Jo tam jāizlemj, ko skaitļi nozīmē. Ja tiek prasīti ieņēmumi no neapstrādātām tabulām, tam jāmin, vai iekļaut PVN, kredītrēķinus, starpuzņēmumu pārdošanu un neapmaksātos rēķinus. Tas izvēlas interpretāciju, pareizi to aprēķina un atgriež skaitli, ko neviens neatpazīst. Aritmētika ir pareiza; definīcija ir izdomāta.
Vai MI var vienkārši lasīt mūsu datubāzi tieši?
Tehniski jā, un tā ir problēma. Ražošanas datubāze ir veidota darījumu rakstīšanai, nevis jautājumu atbildēšanai. Tabulu un kolonnu nosaukumi ir saīsinājumi, biznesa noteikumi dzīvo lietojumprogrammas kodā, nevis datos, un nekas neuzrāda, kura no piecām datuma kolonnām nozīmē, ka pārdošana notikusi.
Vai ir droši dot MI piekļuvi uzņēmuma datiem?
Ir, ja piekļuve ir ierobežota, pirms MI vispār pieslēdzas. Codnity risinājumā tā ir tikai lasīšanai, ierobežota ar tabulām, ko konkrētai komandai ir atļauts redzēt, un reģistrēta. Pārdošanas vadītājam, kas jautā par algām, tiek paziņots, ka tabula nav pieejama, nevis sniegta aizklāta atbilde.
Kas ir semantiskais modelis?
Slānis, kurā katrs biznesa mērs tiek definēts vienreiz. Neto ieņēmumi, aktīvs klients, bruto peļņas norma - katram ir viena definīcija, ko pārmanto katra atskaite un katra MI atbilde, nevis katra to pārrēķina nedaudz citādi.
Vai tas pilnībā novērsīs MI halucinācijas?
Nē, un ikviens, kas apgalvo pretējo, kaut ko pārdod. Tas novērš visbiežāko cēloni biznesa kontekstā, proti, definīciju neviennozīmību. Modelis joprojām var nepareizi izprast neskaidru jautājumu. Atšķirība ir tā, ka atgrieztie skaitļi ir reāli skaitļi no pārvaldītām tabulām, un jebkuru no tiem var detalizēt.
Kā pārbaudīt, vai MI atbilde ir pareiza?
Uzdodot to pašu jautājumu MI un informācijas panelim, kas veidots uz tām pašām tabulām. Tie lasa no viena modelēta slāņa, tāpēc tiem jāsakrīt. Ja nesakrīt, modelī ir robs, un tā ir labojama problēma ar zināmu atrašanās vietu.
Published · Updated · Last reviewed
Autors: Elvijs Veide, Co-founder